注意区分:RTX 6000 Ada(Ada Lovelace,48GB)工作站专业卡,不是 Blackwell 架构 RTX PRO 6000(96GB,新款),很多人容易搞混。
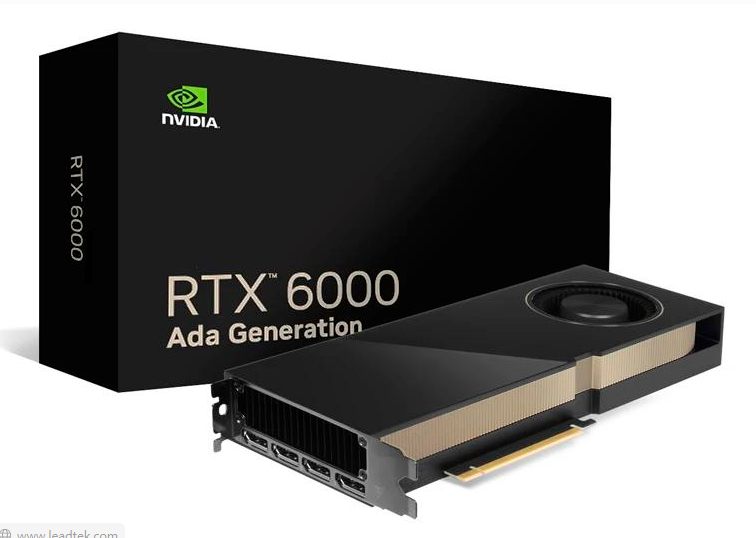
基础规格
- 架构:Ada Lovelace(AD102)
- CUDA 核心:18176;第 4 代 Tensor Core 568;第 3 代 RT Core 142
- 显存:48GB GDDR6,带 ECC 纠错,384bit,带宽 960GB/s
- TDP:300W,PCIe4.0 ×16,双槽涡轮风冷,4×DP1.4a 输出
- FP32:91.1 TFLOPS;FP8 稀疏 AI 算力:1457 TOPSNVIDIA
✅ 优点
- 48GB ECC 显存是最大亮点 对比 RTX4090 的 24GB 无 ECC,单卡 48G 可直接跑 7B/13B 大模型全精度推理、微调;做三维场景、Omniverse、影视 8K 渲染、CAE 仿真,超大场景不爆显存。ECC 显存可以自动修正内存位错误,长时间连续跑任务稳定性强,适合工作站 7×24 小时工作。
两张 24G 4090 不能等效一张 48G,很多 AI / 渲染软件无法跨卡共享显存。
- 图形 + AI 全能一体 不像 A100/A800 这类纯数据中心卡没有显示输出;RTX6000 Ada一边带图形输出,一边支持 CUDA、TensorRT、vGPU 虚拟化。设计师、AI 研究者单台工作站就能兼顾 3D 建模、实时光追渲染、数字人、大模型推理微调。专业驱动对 Maya、Blender、SolidWorks、UE、Omniverse 有专门优化,专业软件稳定性远超游戏卡。
- 功耗控制优秀 300W,FP32 算力略高于 4090,功耗反而低于 4090,工作站整机散热压力更小。
- 支持 vGPU 虚拟化 可虚拟划分多张虚拟工作站显卡,云桌面、远程设计场景可用,这是消费卡不具备的企业级特性。
❌ 短板
- 价格昂贵(2026 市场行情:5~7 万人民币) 算力相比 4090 只提升约 10%,价格是 4090 的 4 倍以上;溢价主要来自48GB ECC 显存、专业驱动、长期稳定性、vGPU 授权。单纯打游戏完全不值。
- 显存带宽弱于 HBM 数据中心卡 对比 A100 40G 的 HBM2e(1555GB/s),GDDR6 带宽低,大规模模型训练不如 A100/A800,更适合推理、小参数微调、图形渲染,不适合大规模分布式训练。
- 没有 NVLink 多卡互联只能走 PCIe,多卡协同性能损失明显,不适合 8 卡集群训练。
- 消费场景完全不划算 游戏性能和 4090 差距很小,价格极高;个人只玩游戏不要考虑。
🧩 适合人群 & 不适合人群
✅ 推荐购买
- 建筑 / 汽车 / 影视三维设计师,超大场景实时渲染、Omniverse 数字孪生
- AI 小团队,本地部署 LLM 推理、13B 模型微调、数字人 / 视频生成,需要单卡大显存,同时要显示器输出
- 工程仿真、CAE、医学影像处理,对长时间稳定、ECC 内存纠错有硬性要求
- 企业云工作站、vGPU 虚拟化桌面
❌ 不推荐
- 纯游戏玩家
- 大规模大模型训练集群(优先 A800/H100)
- 预算有限,只跑轻量 AI 推理(4090D 性价比更高)
2026 横向对比速览
- RTX 6000 Ada:48GB ECC GDDR6,全能工作站,图形 + AI 推理,300W,5w+
- RTX PRO 6000(Blackwell 新卡):96GB GDDR7,算力更强,价格 10w+,面向高端 AI 工作站
- RTX4090:24GB 无 ECC,游戏 + AI 推理,性价比高,无专业认证、无 ECC
- A100/A800 40G:HBM 高带宽,适合大规模训练,无显示输出
一句话总结
RTX6000 Ada 是全能型高端工作站卡,核心价值是48GB ECC 大显存 + 图形显示 + CUDA AI 一体;算力提升有限,溢价极高。如果你需要单卡大显存、专业渲染 + 本地 AI 推理,且预算充足,它是优秀选择;只看算力、游戏、大规模训练,则有更好替代品。
| 倍 | ||
| 总线 | PCIe 4.0 ×16 | PCIe 5.0 ×16 |
| FP32 算力 | 91.1 TFLOPS | 125 TFLOPS |
| AI 算力 FP8 稀疏 | 1457 TOPS | 4000 TOPS |
| TDP | 300W | 标准版 600W;Max-Q 版本 300W |
| 视频编解码 | AV1 编码,NVENC 第 8 代 | NVENC 第 9 代、NVDEC 第 6 代,4 路编解码 |
| 显示输出 | 4×DP1.4a | 4×DP2.1b,支持 8K 高刷 |
| MIG 虚拟化 | vGPU | 支持 MIG,可切分:4×24G / 2×48G /1×96G |
| 市场价格 (2026) | 5~7 万 | 10~16 万 |
✅ RTX PRO 6000 Blackwell 核心提升点
- 显存直接翻倍至 96GB GDDR7 单卡直接容纳 34B 大模型全参数推理 / 微调,超大规模数字孪生、8K 影视、CFD 仿真、医学三维重建不再爆显存;支持 MIG 硬件显存切分,一台显卡虚拟成多块 24G/48G 专业卡给多用户,虚拟化能力远强于老 RTX6000 Ada。
- Blackwell 第五代 Tensor Core 新增 FP4 精度,AI 算力提升巨大,LLM 推理、多模态生成、AI 视频、数字人渲染速度提升2~3 倍;第四代光追核心,路径追踪、Omniverse 实时物理渲染性能显著提升。
- PCIe5.0+GDDR7 高带宽 数据吞吐大幅改善,大模型加载、海量 3D 场景贴图加载速度更快。
- 三版本灵活选型
- Workstation 标准版 600W:性能拉满,单卡最强,双槽长卡,适合单机重度 AI + 渲染工作站;电源要求高,需要新平台。
- Max-Q 300W:功耗和 RTX6000 Ada 一样,涡轮散热,老工作站机箱更容易升级,性能小幅低于 600W 版,是最推荐升级版本。
- Server 版:被动散热,无显示器输出优先,面向多卡服务器集群。
📌 RTX 6000 Ada 的优势(为什么还存在)
- 功耗 300W,对现有工作站电源、散热兼容性更好,老机器可以直接升级,不用换整机电源。
- 价格便宜一半,48G 显存对于 13B 及以下大模型、常规工业 / 建筑三维、中小型 Omniverse 项目足够。
- 成熟稳定,驱动长期验证,项目落地案例多,供应链现货充足。
🎯 场景选型对比
👉 选 RTX PRO 6000 Blackwell
- 需要单卡 96GB 超大显存,跑 30B + 大模型微调、多模态大模型、超大场景数字孪生
- 重度 AI 视频生成、多视角数字人、超大 CAE/CFD 仿真
- 企业云工作站,需要 MIG 硬件虚拟化,多人共享一张 GPU
- 新装机、预算充足,追求未来 3~5 年不淘汰
👉 选 RTX 6000 Ada
- 现有工作站升级,电源只能承受 300W
- 模型上限 13B 以内、常规三维渲染、建筑 BIM、中等规模数字孪生
- 预算有限,需要专业 ECC 显存、专业驱动,但不需要 96G 显存
- 不做大规模大模型训练,以推理 + 可视化为主
⚠️ 共同短板
- 无 NVLink:多卡之间只能走 PCIe,多卡协同训练性能损耗大,大规模训练集群依然优先 H100/H200 数据中心卡。
- 价格昂贵,纯游戏完全不推荐。
一句话总结
RTX PRO 6000 Blackwell 是全面换代升级:显存翻倍、GDDR7、Blackwell 第五代 Tensor Core、PCIe5.0,AI 和超大场景渲染能力质变,但价格更高,高功耗版本对整机平台要求高;RTX6000 Ada 属于上代成熟全能工作站卡,48G 显存够用、功耗友好、性价比更高,适合中等规模 AI 推理 + 三维可视化。
👀 阅读量:22 次